Una frase como “escribime algo para vender más” deja abiertas casi todas las decisiones: producto, audiencia, canal, tono, objetivo y extensión. El asistente puede completar esos huecos, pero lo hará con supuestos que quizá no coincidan con el negocio.
Para observar qué cambia cuando la instrucción se vuelve explícita, revisamos las 120 versiones que forman la biblioteca de prompts de Lumada Labs: 40 plantillas localizadas en español, inglés y portugués. Después contrastamos sus componentes con la documentación pública de OpenAI, Anthropic y Google.
Metodología y alcance
La unidad de análisis fue cada versión localizada de una plantilla. Revisamos si declaraba objetivo, contexto, entrada, pasos, formato de salida, restricciones y una forma de controlar datos faltantes o afirmaciones no verificadas.
Este trabajo es un análisis estructural, no un ranking ni un benchmark automático de modelos. No sostiene que las 120 versiones sean 120 tareas independientes ni que una misma respuesta vaya a repetirse: los modelos generativos pueden producir resultados diferentes ante una misma instrucción.
Cómo se hizo: el 26 de septiembre de 2026 inspeccionamos las 40 plantillas base en español y comprobamos sus 80 localizaciones en inglés y portugués. Buscamos encabezados y reglas explícitas; después revisamos manualmente los casos para evitar contar una palabra fuera de contexto. El corpus completo puede consultarse en la biblioteca de prompts.
Los datos del corpus
Las 40 plantillas base no usan una fórmula idéntica, pero la mayoría hace visibles los componentes que reducen ambigüedad. Este es el recuento reproducible sobre la versión en español:
| Componente explícito | Plantillas | Proporción |
|---|---|---|
| Contexto | 37 de 40 | 92,5 % |
| Reglas o controles verificables | 36 de 40 | 90 % |
| Tarea separada y accionable | 29 de 40 | 72,5 % |
| Manejo de información faltante | 22 de 40 | 55 % |
| Fuentes o verificación | 17 de 40 | 42,5 % |
El recuento mide presencia textual, no calidad de respuesta. Sirve para describir cómo está construida la biblioteca y permite que otra persona revise la conclusión sobre el mismo material.
1. Una tarea concreta funciona mejor que una intención general
El patrón más estable empieza con un verbo observable: comparar, resumir, diagnosticar, escribir, clasificar o planificar. “Ayudame con marketing” expresa un tema. “Compará estas dos campañas y devolvé una tabla con hipótesis, evidencia y próximos pasos” define un trabajo.
OpenAI recomienda instrucciones específicas y descriptivas. Anthropic insiste en ser claro y directo. Google plantea lo mismo para Gemini: explicar de manera precisa el objetivo y las restricciones. La coincidencia entre las tres guías es más importante que la forma exacta de redactarla.
2. El contexto reduce los supuestos silenciosos
Una instrucción útil explica para qué se necesita el resultado, quién lo va a usar y qué información ya existe. En las plantillas analizadas, esta capa suele aparecer como audiencia, objetivo, material de referencia y límites del caso.
Agregar contexto no significa escribir páginas de introducción. Significa incluir los datos que cambiarían la decisión. Para un email comercial pueden ser el destinatario, la relación previa y la acción esperada. Para revisar código serán el lenguaje, el error, el comportamiento correcto y las restricciones técnicas.
3. Separar instrucciones, datos y ejemplos evita confusiones
Los tres proveedores recomiendan distinguir las partes del prompt. OpenAI propone delimitadores; Anthropic utiliza etiquetas XML; Google acepta etiquetas o encabezados Markdown. En todos los casos, la función es la misma: señalar qué parte contiene reglas, cuál contiene contexto y cuál es el material que debe procesarse.
Esta separación es especialmente útil cuando el usuario pega documentos, correos, código o información obtenida de terceros. El contenido pasa a ser entrada del trabajo y no una continuación ambigua de las instrucciones.
4. Pedir el formato de salida vuelve el resultado evaluable
“Dame una buena respuesta” no define qué significa buena. Una tabla comparativa con cinco criterios, un email de menos de 180 palabras o un plan con responsables y fechas sí puede revisarse.
Las mejores plantillas de la biblioteca especifican estructura, extensión, tono y nivel técnico. Cuando la forma exacta importa, también incluyen un ejemplo breve. Las guías oficiales coinciden en que los ejemplos ayudan a dirigir formato y consistencia.
5. Las reglas útiles describen calidad, no acumulan adjetivos
Pedir que la respuesta sea “excelente, increíble y profesional” agrega poco. Es más útil indicar que no invente cifras, que diferencie hechos de supuestos, que cite fuentes cuando corresponda o que haga preguntas si falta un dato imprescindible.
Una regla debe permitir detectar un error. “No inventes fuentes” es comprobable. “Sé brillante” no lo es.
6. El rol ayuda cuando aporta un criterio concreto
Asignar un rol puede orientar vocabulario, prioridades y nivel técnico, pero no reemplaza la tarea. “Actuá como especialista en ventas B2B” sirve si después se explica qué debe producir, para quién y con qué evidencia. Un personaje grandilocuente sin contexto no corrige una instrucción vaga.
La estructura común
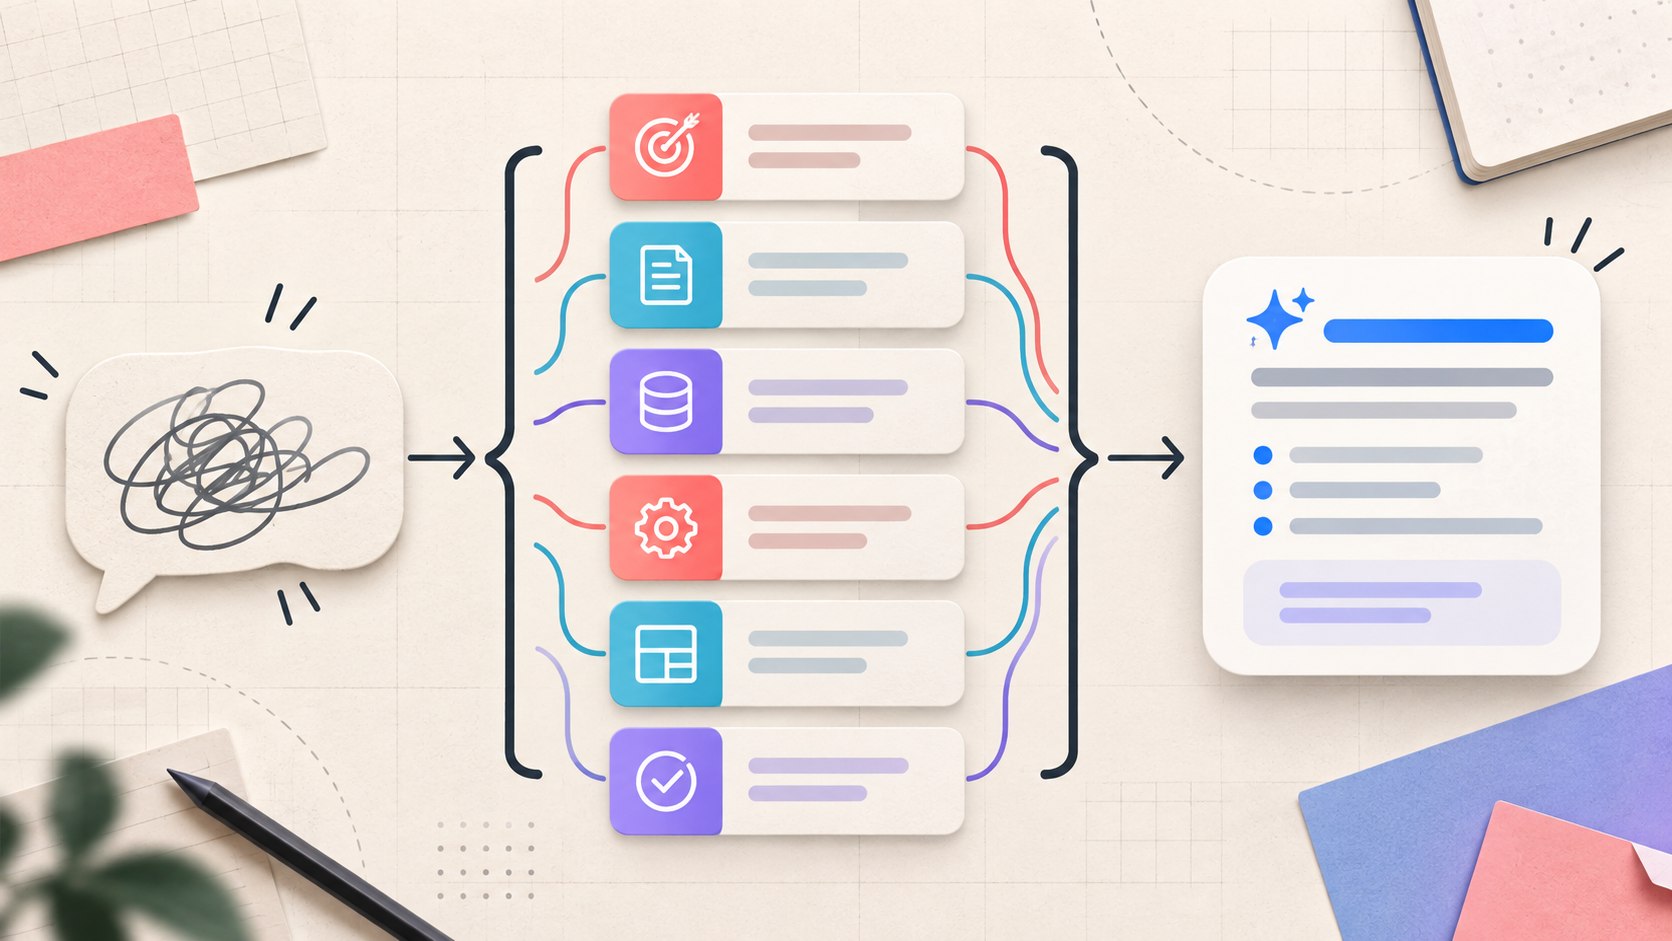
El patrón que emerge del análisis puede resumirse en seis bloques:
- Objetivo: qué resultado debe quedar resuelto.
- Contexto: para qué, para quién y con qué información.
- Entrada: texto, datos, archivos o variables que debe procesar.
- Tarea: acciones concretas y orden cuando sea necesario.
- Formato: estructura, extensión, tono y nivel de detalle.
- Control: límites, fuentes, supuestos y revisión final.
No todos los pedidos necesitan los seis bloques. Una pregunta simple puede resolverse en una línea. La estructura gana valor cuando la tarea es ambigua, repetible, costosa o sensible a errores.
Qué cambia entre ChatGPT, Claude y Gemini
Las recomendaciones generales convergen, pero cada producto tiene capacidades y comportamientos propios. Una plantilla reutilizable debería conservar el objetivo, el contexto y el formato, y adaptar después herramientas, longitud de contexto, uso de ejemplos o instrucciones de sistema según el modelo y la tarea.
La conclusión práctica no es buscar una frase secreta que funcione siempre. Es diseñar una instrucción que otra persona también podría ejecutar sin adivinar lo esencial, probarla con un caso real y ajustarla a partir del resultado.
Fuentes
Autoría, revisión y correcciones
Priscila Soares realizó el análisis editorial y redactó esta nota. Lumada Labs revisó los enlaces, el recuento y la correspondencia entre las afirmaciones y las fuentes citadas. Se utilizó asistencia de IA para ordenar borradores; la selección del corpus, la verificación y la versión publicada tuvieron revisión humana.
Consultá nuestra política editorial y de correcciones. Si encontrás un dato que requiere revisión, escribinos a hola@lumadalabs.com indicando la URL y el fragmento.